Michele Eccher
W tym poradniku
Aby crawlery AI miały dostęp do Twojej strony, dopuść te, na których Ci zależy, i sprawdź, czy faktycznie dostają publiczne podstrony. Zgoda w robots.txt może nie wystarczyć: zapora potrafi odrzucić żądanie, a serwer może zamiast treści zwrócić ekran weryfikacji. Zacznij więc od decyzji, jaki dostęp chcesz dać. Wyszukiwanie, trenowanie modeli i odwiedziny na prośbę użytkownika mają osobne ustawienia.
Plan testów poniżej obejmuje 32 próby na czterech adresach URL. Pomaga znaleźć przeszkodę i zebrać dowody dla osoby, która ją usunie. Jeśli chcesz dodatkowo ocenić jakość treści i obecność marki w odpowiedziach AI, przejdź do audytu widoczności w wyszukiwarkach AI.
Które crawlery służą wyszukiwaniu, a które trenowaniu?
Zanim zmienisz robots.txt, zdecyduj, czy zezwalasz na wyszukiwanie, trenowanie modeli, czy na oba zastosowania. Dla funkcji AI w wyszukiwarce Google, w tym przeglądu od AI i Trybu AI, właściwym crawlerem jest Googlebot. Google-Extended określa, czy treści mogą służyć do trenowania Gemini oraz jako źródła odpowiedzi w wybranych innych produktach Google. Ten proces nazywa się groundingiem. Google-Extended to token używany w robots.txt, a nie osobny user-agent HTTP, którego należałoby szukać w logach. Nie wpływa na obecność w wyszukiwarce Google ani na pozycje.
| System | Udokumentowany cel | Decyzja techniczna |
|---|---|---|
| Googlebot | Wyszukiwarka Google, w tym jej funkcje AI | Zarządzać skanowaniem i tym, czy strona kwalifikuje się do wyświetlania fragmentów |
| Google-Extended | Trenowanie Gemini i wykorzystanie źródeł w odpowiedziach w produktach wskazanych przez Google | Zdecydować o tym niezależnie od wyszukiwarki |
| OAI-SearchBot | Wyszukiwarka ChatGPT | Zezwolić na skanowanie dla wyszukiwarki albo je zablokować |
| GPTBot | Zbieranie treści, które mogą posłużyć do trenowania modeli OpenAI | Zdecydować o trenowaniu niezależnie od wyszukiwarki |
| ChatGPT-User | Pobieranie stron w ramach niektórych działań zlecanych przez użytkownika | Nie traktować go jako zamiennika OAI-SearchBot |
| PerplexityBot | Wyszukiwanie źródeł do wyników Perplexity, bez trenowania modeli bazowych | Sprawdzić reguły i dostęp dla wyszukiwarki |
| Perplexity-User | Pobieranie stron na prośbę użytkownika, bez automatycznego skanowania i trenowania | Odróżnić te wizyty od crawlera wyszukiwarki |
Wizyty na prośbę użytkownika podlegają innym zasadom niż automatyczne skanowanie. Według OpenAI robots.txt może nie dotyczyć ChatGPT-User, a według Perplexity Perplexity-User zwykle go ignoruje. Prywatne treści chroń więc logowaniem. Aktualne nazwy i cele sprawdzaj w dokumentacji OpenAI, Perplexity oraz w katalogu crawlerów Google, zwłaszcza po zmianach w systemach dostawcy.
Jak napisać i sprawdzić robots.txt
Otwórz /robots.txt na tym samym hoście, z tym samym protokołem i portem co sprawdzane strony. Dla https://example.com/services/ będzie to https://example.com/robots.txt. Reguły z tego pliku nie dotyczą https://www.example.com. Przed zmianami zapisz bieżący plik. Po wdrożeniu otwórz publiczny plik ponownie i sprawdź, czy CMS albo proces publikacji nie nadpisał zmian.
Załóżmy, że firma chce, aby ChatGPT znajdował jej publiczne strony, ale nie pozwala GPTBotowi zbierać treści do trenowania. W przykładzie poniżej /private/ to przykładowa ścieżka, której dane i tak trzeba chronić logowaniem. Ograniczenie występuje także w grupie OAI-SearchBot, ponieważ grupa szczegółowa nie dziedziczy automatycznie reguł z grupy *. Jeśli plik zawiera kilka grup dla tego samego crawlera albo ścieżki, które się nakładają, sprawdź w Robots Exclusion Protocol, które reguły obowiązują.
Dostosuj przykład do swojego pliku i zachowaj pozostałe potrzebne ograniczenia oraz adresy map witryny. Ścieżka, która nie jest zablokowana, nie wymaga dyrektywy Allow: /. Przed zamknięciem zadania porównaj publiczny plik z zatwierdzoną wersją.
User-agent: *
Disallow: /private/

User-agent: OAI-SearchBot
Disallow: /private/

User-agent: GPTBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Jakie dyrektywy i nagłówki na stronie warto sprawdzić?
Żeby strona mogła pojawić się jako link pomocniczy w przeglądzie od AI lub w Trybie AI, musi według Google być zindeksowana i kwalifikować się do wyświetlania fragmentu w wynikach. Sprawdź zarówno metatag robots w HTML-u, jak i X-Robots-Tag w końcowych nagłówkach odpowiedzi HTTP. Na przykład CDN, który dostarcza Twoje strony, może dodać noindex, którego nie ma w HTML-u. Wśród ustawień fragmentów w Google są nosnippet, max-snippet i data-nosnippet. Nie zakładaj, że te ustawienia działają tak samo na każdej platformie.
| Kontrola | Na co zwrócić uwagę | Gdy wynik jest nieoczekiwany |
|---|---|---|
| Indeksowanie | noindex w metatagu robots lub w X-Robots-Tag | Ustalić, czy pochodzi ze strony, serwera czy CDN, i poprawić tę konfigurację |
| Fragmenty | nosnippet, max-snippet i sekcje oznaczone data-nosnippet | Porównać ograniczenie z informacjami, które mają być dostępne |
| Adres kanoniczny | Stabilny, dostępny adres kanoniczny zgodny ze stroną | Poprawić nieaktualne lub nieindeksowalne adresy docelowe |
| Wersje językowe | Wzajemne linki hreflang między opublikowanymi wersjami językowymi | Wykluczyć wersje robocze i niedostępne języki |
Jeśli robots.txt blokuje pobranie strony, wyszukiwarka nie odczyta jej dyrektywy noindex. Zezwól na pobieranie, żeby mogła ją przetworzyć. W narzędziu do sprawdzania adresów URL w Search Console zobacz HTML, który otrzymał Google. Znacznik w repozytorium sam nie dowodzi, że dotarł do wyszukiwarki.
OpenAI odróżnia też odpowiedzi wyszukiwarki od linków nawigacyjnych. Witryna, która blokuje OAI-SearchBot, może nadal pojawić się jako link nawigacyjny. Zablokowanie skanowania nie usuwa każdego odwołania do domeny.
Plan testów na start: 32 próby na czterech adresach URL
Wybierz cztery różne publiczne strony, które należą do Ciebie albo które możesz testować. Oznacz stronę usługi jako U1, poradnik jako U2, niedawno zaktualizowaną stronę jako U3, a stronę z treścią zależną od JavaScriptu jako U4. Jeśli nie masz strony tego ostatniego typu, wybierz taką, która ma inną budowę niż pozostałe trzy. Nawet gdy jeden adres spełnia dwa kryteria, znajdź czwartą, odrębną stronę. Taki zestaw stron wystarcza do wstępnej diagnozy; przy serwisie z wieloma typami stron potrzebne będą dalsze kontrole. Używaj adresów, które chcesz udostępnić. Celowe wyłączenia notuj, zamiast je usuwać tylko po to, by uzyskać pomyślny wynik.
Dla każdego adresu wyślij cztery żądania GET, po jednym na profil, a później powtórz je. Pierwszą rundę nazwij R1, drugą R2: 4 adresy × 4 profile × 2 rundy = 32 próby. Użyj CTRL dla AuditCrawler/1.0, GOOG dla Googlebot/2.1 (+http://www.google.com/bot.html), OAI dla OAI-SearchBot/1.4 i PPLX dla PerplexityBot/1.0. Te ciągi user-agent służą tylko do porównywania odpowiedzi; prawdziwe boty mogą używać pełnych ciągów i innych wersji. Wysyłaj żądania pojedynczo i zapisuj znacznik czasu każdego z nich. Przekierowania dodają kolejne żądania sieciowe ponad 32 zaplanowane próby.
Przygotowanie i odczyt dowodów
- Zapisz robots.txt i mapę witryny osobno; ich pobranie nie wlicza się do 32 prób. Najpierw przeczytaj obowiązujące reguły. Polecenie curl nie przestrzega robots.txt i może pobrać wyłączony adres.
- Wybierz na każdej stronie istotne sformułowanie, na przykład warunek usługi, i szukaj go w zapisanym HTML-u. Dzięki temu rozpoznasz oczekiwaną treść.
- W poleceniu zmień adres URL i user-agent oraz dostosuj nazwy plików. U1-CTRL-R1 oznacza pierwszą próbę na stronie usługi z profilem kontrolnym, a U1-OAI-R2 drugą rundę z profilem OAI.
- Każde przekierowanie tworzy w pliku nagłówków osobny blok. Prześledź wartości Location i odczytaj status, Content-Type oraz X-Robots-Tag końcowej odpowiedzi. W HTML-u poszukaj metatagu robots, adresu kanonicznego, istotnego sformułowania i linków.
- Jeśli otrzymasz kod 429, przestań powtarzać żądania i sprawdź nagłówek Retry-After oraz limity serwisu. Przy przekroczeniu czasu lub błędach sieci zapisz kod wyjścia curl: próba mogła nie dostać żadnej odpowiedzi HTTP.
Poniższe polecenie wysyła żądanie GET i zapisuje nagłówki oraz treść odpowiedzi. Żądanie HEAD pobiera tylko nagłówki, więc nie pokaże ekranu weryfikacji zwracanego ze statusem 200. W PowerShellu użyj curl.exe, by uniknąć aliasu w niektórych wersjach; w macOS i Linuksie wystarczy curl. Uruchom polecenie w osobnym folderze po zamianie przykładowej domeny. Limit 30 sekund przerywa test, który się nie kończy; nie jest progiem SEO.
curl -sS -L --max-redirs 5 --connect-timeout 10 --max-time 30 -A "AuditCrawler/1.0" -D U1-CTRL-R1-headers.txt -o U1-CTRL-R1.html -w "HTTP=%{http_code} URL=%{url_effective} BYTES=%{size_download}\n" "https://example.com/services/"Jak zweryfikować tożsamość bota i zbadać blokadę przez WAF
Testy curl wychodzą z Twojego adresu IP, nawet jeśli ustawisz user-agent crawlera. Mogą ujawnić filtr na tę nazwę, ale nie odtwarzają każdej cechy prawdziwego żądania crawlera. Kod 403 przy nazwie OAI-SearchBot nie dowodzi więc jeszcze, że serwis blokuje OpenAI. Sprawdź prawdziwe żądania crawlerów i ustal, skąd pochodzą.
Zapora aplikacji internetowej (WAF) filtruje żądania sieciowe. Gdy stoi przed serwerem, może odrzucić wizytę, zanim ta dotrze do serwisu. Szukaj żądań do swoich przykładowych adresów w logach WAF lub CDN oraz w logach serwera źródłowego. Zapisz datę, godzinę i strefę czasową, adres IP odwiedzającego, user-agent, adres URL, status HTTP, liczbę zwróconych bajtów i każdą zastosowaną regułę. Jeśli identyfikator żądania występuje w obu logach, połącz nim wpisy. Jeśli nie, porównaj adres URL, czas i IP, zaznaczając ograniczenia takiego dopasowania. Gdy przed serwerem działa proxy, zapytaj operatora, które pole logu zawiera adres IP odwiedzającego zweryfikowany przez infrastrukturę. Nagłówek, który odwiedzający mogą ustawiać dowolnie, nie jest wiarygodnym dowodem.
W przypadku Google postępuj według oficjalnej instrukcji weryfikacji żądań. Porównaj adres IP z odpowiednią listą opublikowaną przez Google. Możesz też wykonać wyszukiwanie odwrotne DNS, aby poznać nazwę hosta przypisaną do IP. Sprawdź, czy należy do domeny oczekiwanej dla tego crawlera, a następnie wykonaj dla tej nazwy hosta wyszukiwanie wprost. Wynik musi zawierać pierwotny adres IP. Sama nazwa hosta ze słowem „google” nie wystarczy.
Przy OpenAI i Perplexity sprawdź, czy adres IP mieści się w zakresach z plików JSON, do których odsyła dokumentacja. Zapisz kopię listy i datę kontroli, bo zakresy mogą się zmieniać. Perplexity zaleca, by w regułach zapory dopasowywać jednocześnie IP i user-agent. Jeśli nie możesz zweryfikować pochodzenia, wpisz „tożsamość niezweryfikowana”. Sama nazwa bota nie uzasadnia wyjątku w WAF.
Jeśli WAF blokuje zweryfikowanego crawlera, którego chcesz dopuścić, administrator zapory powinien zmienić regułę dla tego ruchu i dla publicznych stron, których dotyczy blokada. Uwierzytelnianie i ochrona wrażliwych funkcji pozostają włączone. Przed zmianą zapisz dotychczasową regułę i wskaż osobę, która może ją przywrócić. Potem powtórz testy na tych adresach.
Reguła skanowania
Czy właściwa grupa w robots.txt pozwala pobrać stronę? Zanotuj każde celowe wyłączenie, zanim zaczniesz testy.
Odpowiedź publiczna
Czy zapora lub serwer zwraca oczekiwaną stronę, czy ekran ochrony przed botami? Porównaj status HTTP, nagłówki i treść.
Dostępna treść
Czy najważniejszy tekst jest już w HTML-u, czy pojawia się dopiero po kliknięciu? Sprawdź też linki, dyrektywy i adres kanoniczny.
Czy odpowiedź 200 faktycznie zawiera stronę?
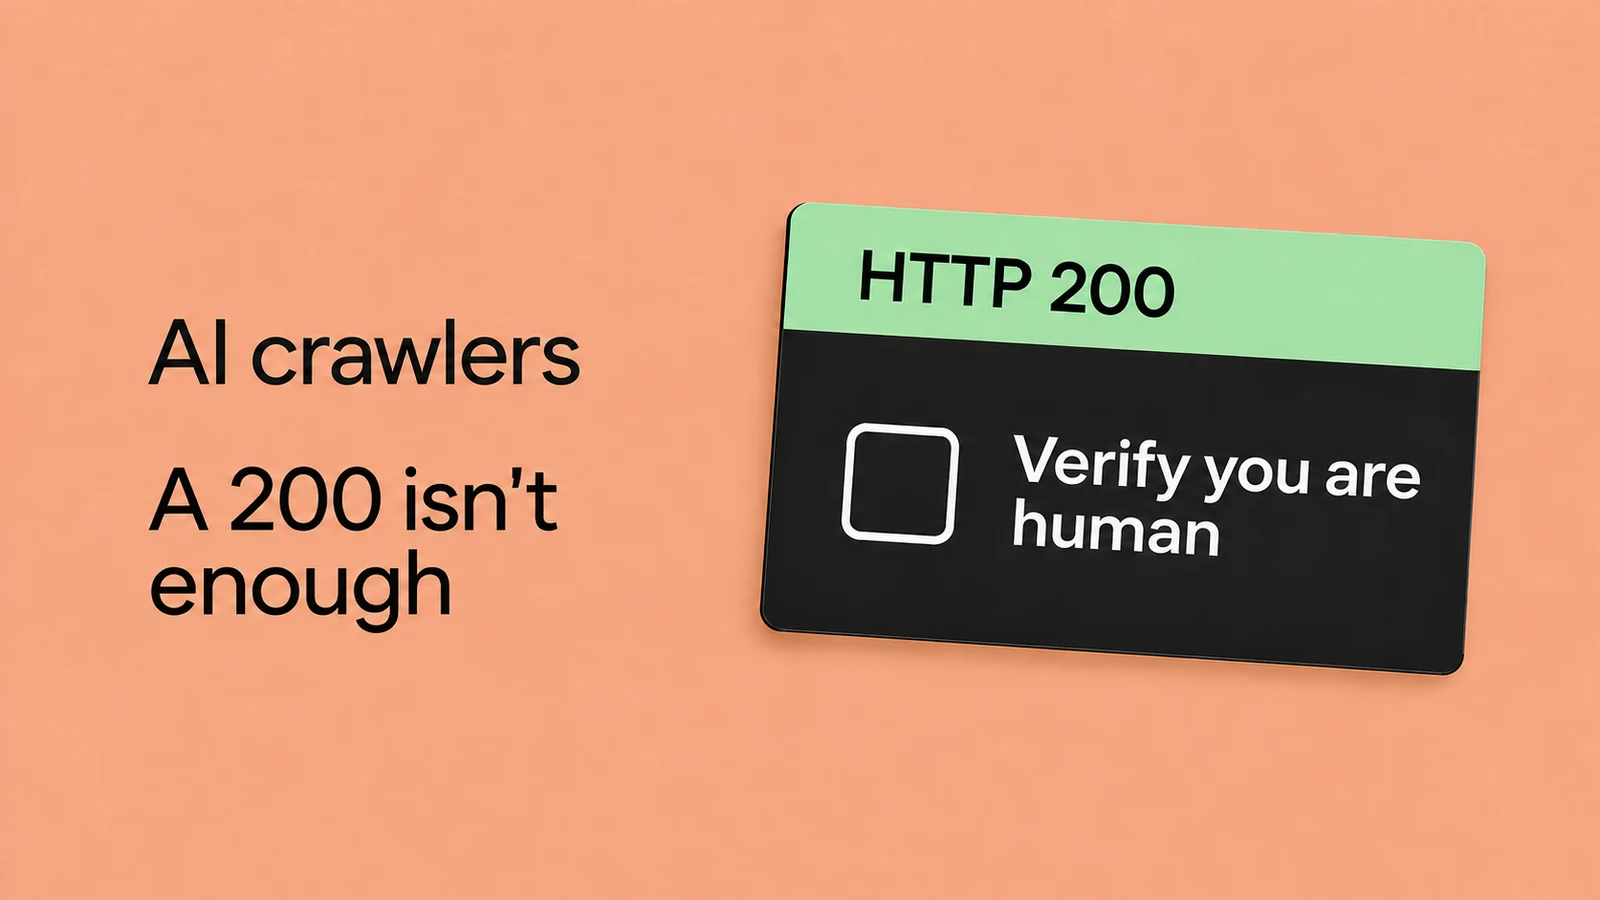
Otwórz zapisany plik HTML i porównaj go ze stroną w przeglądarce, bez logowania. Odpowiedź 200 może zawierać komunikat „potwierdź, że jesteś człowiekiem”, formularz logowania albo stronę błędu. Dzięki istotnemu sformułowaniu wybranemu przed testem odróżnisz oczekiwaną stronę od takich odpowiedzi i nie musisz polegać wyłącznie na kodzie statusu.
Jeśli sformułowania brakuje w zapisanym HTML-u, ale pojawia się po załadowaniu strony przez przeglądarkę, sprawdź treści dodawane przez JavaScript i ewentualne błędy skryptów. Google potrafi przetwarzać JavaScript, ale z tego nie wynika, że inne systemy AI uruchamiają te same skrypty. Jeśli chodzi o Google, obejrzyj pobrany HTML w narzędziu do sprawdzania adresów URL. U innych dostawców porównaj udokumentowane możliwości ze swoimi dowodami. Jeśli ważne publiczne informacje pojawiają się dopiero po kliknięciu lub zgodzie na pliki cookie, poproś programistę, by udostępnił je bez tych interakcji. Prywatne treści powinny pozostać za logowaniem.
Sprawdź, czy linki do ważnych stron mają adres w atrybucie href, tabele czytelne nagłówki, a obrazy niosące informację odpowiedni tekst alternatywny. Google potrzebuje też dostępu do plików CSS i JavaScript wymaganych do wyrenderowania strony. Jeśli problem dotyczy kilku typów stron, skorzystaj z poradnika o audycie technicznym SEO.
Jak zapisywać i interpretować wyniki
Dla każdego identyfikatora testu, na przykład U1-CTRL-R1, wpisz OK, gdy test zwrócił oczekiwaną treść, BŁĄD, gdy ujawnił blokadę lub inną stronę, oraz NIEZWERYFIKOWANE, jeśli testu brakuje albo nie jest rozstrzygający. Zapisz status HTTP i zachowaj pliki z odpowiedziami. Weryfikację tożsamości prowadź osobno: wynik OK dla Twojego żądania testowego nie potwierdza dostępu prawdziwego bota.
| Obserwacja | Możliwe wyjaśnienie | Następna kontrola |
|---|---|---|
| 403 tylko dla jednego testowego user-agenta | Zapora może filtrować nazwę lub inną cechę żądania | Znaleźć zastosowaną regułę i sprawdzić, czy blokuje także prawdziwe żądania crawlerów |
| 200 z ekranem ochrony przed botami | Odpowiedź dotarła, ale brakuje oczekiwanej treści | Znaleźć żądanie w logach WAF, by ustalić filtr, który wyświetlił ekran ochrony |
| 429 lub sporadyczne błędy 5xx | Serwis może ograniczać liczbę żądań albo mieć problemy z dostępnością | Wstrzymać testy i poprosić operatora o sprawdzenie Retry-After, logów i dostępności przed ponowną próbą |
| Tekst pojawia się dopiero po uruchomieniu JavaScriptu | Tekst zależy od wykonania skryptów | Porównać zapisany HTML ze stroną w przeglądarce i sprawdzić, jak dostawca obsługuje skrypty |
| Brak wizyt w dostępnych logach | W tym okresie nie zaobserwowano żadnego żądania; samo to nie dowodzi blokady | Sprawdzić, jakie żądania rejestrują logi i czy linki oraz mapy witryn umożliwiają odnalezienie adresów |
Po poprawce powtórz cztery nieudane kombinacje i upewnij się, że dostęp dla pozostałych profili się nie zmienił. Nowe pliki zapisz w folderze nazwanym datą ponownego testu, a wcześniejsze zachowaj do porównania. Jeśli potem zaobserwujesz, że bot o zweryfikowanej tożsamości dostaje stronę, potwierdzasz, że w tamtej chwili miał dostęp. Indeksowanie i cytowanie jako źródła nadal trzeba sprawdzić osobno.
Jak sprawdzić odnajdywanie stron, gdy dostęp już działa?
Linkuj do ważnych stron z innych powiązanych podstron serwisu, a adresy kanoniczne, które mają być zindeksowane, umieść w mapie witryny. Sprawdź, czy publiczna mapa witryny jest dostępna i czy lastmod, czyli data ostatniej modyfikacji, zmienia się po istotnej aktualizacji treści. Linki i mapy witryn pomagają crawlerom odkrywać adresy URL, ale nie gwarantują wizyty ani cytowania.
W narzędziu do sprawdzania adresów URL w Search Console odczytaj datę ostatniego skanowania i sprawdź, czy adres kanoniczny wybrany przez Google zgadza się z zamierzonym. Jeśli skanowanie odbyło się przed poprawką, pobrany HTML może jeszcze pokazywać starą wersję. Test wersji opublikowanej sprawdza bieżące pobranie, ale sam nie aktualizuje statusu indeksowania. Zapisz zarówno datę zmiany, jak i datę kontroli, żeby wiedzieć, której wersji dotyczy każdy wynik.
Do funkcji AI w Google nie potrzeba specjalnych plików AI ani znaczników Schema.org. Obowiązują zwykłe wymagania techniczne wyszukiwarki. Obecność pliku llms.txt nie świadczy o dostępie ani o kwalifikowaniu się do wyświetlania. Jeśli dostęp jest potwierdzony, a serwis nie jest cytowany, skorzystaj z poradnika o mierzeniu widoczności w wyszukiwarkach AI, by śledzić odpowiedzi i źródła w dłuższym czasie.
Dziennik testów i przekazanie zespołowi
W dzienniku testów umieść konfigurację wyjściową, osiem wyników testów dla każdego adresu URL oraz podsumowanie ustaleń i poprawek. Utwórz 32 wiersze, po jednym na próbę. Nagłówki, HTML i pliki logów trzymaj razem w jednym folderze, z tymi samymi identyfikatorami co w dzienniku testów.
Przekazując dziennik administratorowi serwisu, dołącz publiczne reguły i swoje decyzje dotyczące wyszukiwania i trenowania. Wskaż, które strony i profile zostały przetestowane, których kontroli brakuje i jakie tożsamości udało się zweryfikować. Przy każdej poprawce zapisz problem, osobę odpowiedzialną i termin ponownego testu. Jeśli nie masz dostępu do logów WAF ani CDN, oznacz weryfikację tożsamości jako NIEZWERYFIKOWANE i poproś dostawcę hostingu o żądania odpowiadające zapisanym adresom URL i znacznikom czasu.
Najczęstsze pytania o crawlery AI
Czy potrzebuję osobnej grupy w robots.txt dla każdego crawlera?
Tylko wtedy, gdy chcesz ustalić reguły dla konkretnego crawlera. Bez pasującej grupy szczegółowej obowiązuje grupa ogólna, a ścieżki bez ograniczeń są dozwolone. Gdy tworzysz grupę, dodaj do niej wszystkie ograniczenia, które nadal mają obowiązywać, bo reguły grupy * nie łączą się z nią automatycznie.
Jak długo czekać po zmianie robots.txt?
Według OpenAI systemy wyszukiwania mogą potrzebować około 24 godzin, by uwzględnić zmianę. Nie gwarantuje to nowej wizyty ani cytowania. Zapisz, kiedy publikujesz plik, i szukaj w logach kolejnych żądań. Terminy poszczególnych dostawców znajdziesz w ich dokumentacji.
Czy bot może dostać inną stronę niż zwykli odwiedzający?
Tak. Zapora może pokazać mu ekran ochrony przed botami, a serwer przekierować go do logowania. Znajdź i usuń przeszkodę na stronach, które mają być publiczne, i dbaj o to, by zasadnicza treść była taka sama dla odwiedzających i crawlerów. Tworzenie tekstów wyłącznie dla botów może naruszać zasady wyszukiwarki i uniemożliwia rzetelne porównanie z tym, co czytają odwiedzający.
Jak sprawdzić, czy plik PDF może zostać zindeksowany?
Sprawdź X-Robots-Tag w odpowiedzi HTTP dla pliku PDF: dyrektywa noindex oznacza prośbę o wyłączenie z indeksu Google. PDF nie zawiera metatagu robots z HTML-a, a Google musi mieć możliwość pobrania pliku, aby odczytać ten nagłówek. Czy plik jest już w indeksie, zobaczysz, sprawdzając adres URL pliku PDF w Search Console.